
08/06/2026
În era digitală, inteligența artificială (AI) a devenit un pilon esențial în nenumărate domenii, de la asistenți virtuali la analize complexe în domeniul sănătății și fitness-ului. Cu toate acestea, implementarea modelelor AI complexe pe dispozitive cu resurse limitate, cum ar fi smartphone-uri, wearables sau senzori IoT, reprezintă o provocare semnificativă. Aici intervine conceptul de cuantizare, o tehnică puternică de optimizare care transformă modelele voluminoase și consumatoare de resurse în versiuni mai ușoare și mai rapide. În acest articol, vom explora în detaliu Antrenamentul Conștient de Cuantizare (Quantization Aware Training - QAT), o metodă avansată care te ajută să obții performanță maximă fără a sacrifica precizia.
" + "
Modelele de rețele neuronale, în special cele antrenate pentru sarcini complexe precum recunoașterea imaginilor sau procesarea limbajului natural, sunt adesea construite cu un număr mare de parametri, reprezentați de obicei prin numere în virgulă mobilă de precizie mare (de exemplu, float32). Această precizie este esențială în timpul antrenamentului pentru a asigura convergența și o performanță optimă. Însă, odată ce modelul este antrenat și gata de implementare, aceste numere de precizie ridicată devin o povară. Necesită o cantitate mare de memorie pentru stocare, un consum energetic sporit și o putere de calcul considerabilă pentru inferență, făcându-le nepractice pentru dispozitivele cu resurse limitate (cunoscute și sub denumirea de dispozitive edge).
" + "
- De Ce Avem Nevoie de Cuantizare?
- Ce Este Antrenamentul Conștient de Cuantizare (QAT)?
- Cum Creăm un Model Keras Conștient de Cuantizare (QAT)?
- Experimentarea cu Cuantizarea (Cazuri Avansate)
- Comparație: Cuantizare Post-Antrenament (PTQ) vs. Antrenament Conștient de Cuantizare (QAT)
- Întrebări Frecvente (FAQ)
- Concluzie
De Ce Avem Nevoie de Cuantizare?
" + "
Problema fundamentală constă în discrepanța dintre cerințele de resurse ale modelelor AI moderne și capacitățile limitate ale hardware-ului pe care dorim să le rulăm. Un model de rețea neuronală mare poate ocupa zeci sau sute de megabytes, ceea ce este inacceptabil pentru un senzor inteligent sau un ceas fitness. Mai mult, operațiile cu numere în virgulă mobilă sunt lentă și consumatoare de energie comparativ cu cele cu numere întregi. Cuantizarea abordează aceste probleme prin reducerea preciziei numerice a parametrilor și activărilor modelului, de obicei de la float32 (32 de biți) la int8 (8 biți). Această reducere are un impact direct asupra:
" + "
- " + "
- Dimensiunii modelului: Un model int8 este de aproximativ 4 ori mai mic decât echivalentul său float32.
- Vitezei de inferență: Operațiile cu numere întregi sunt mult mai rapide pe majoritatea hardware-ului, ducând la o latență redusă.
- Consumului de energie: Mai puține operații complexe și o utilizare mai eficientă a memoriei înseamnă un consum de energie mai mic, crucial pentru dispozitivele alimentate cu baterii.
" + "
" + "
" + "
" + "
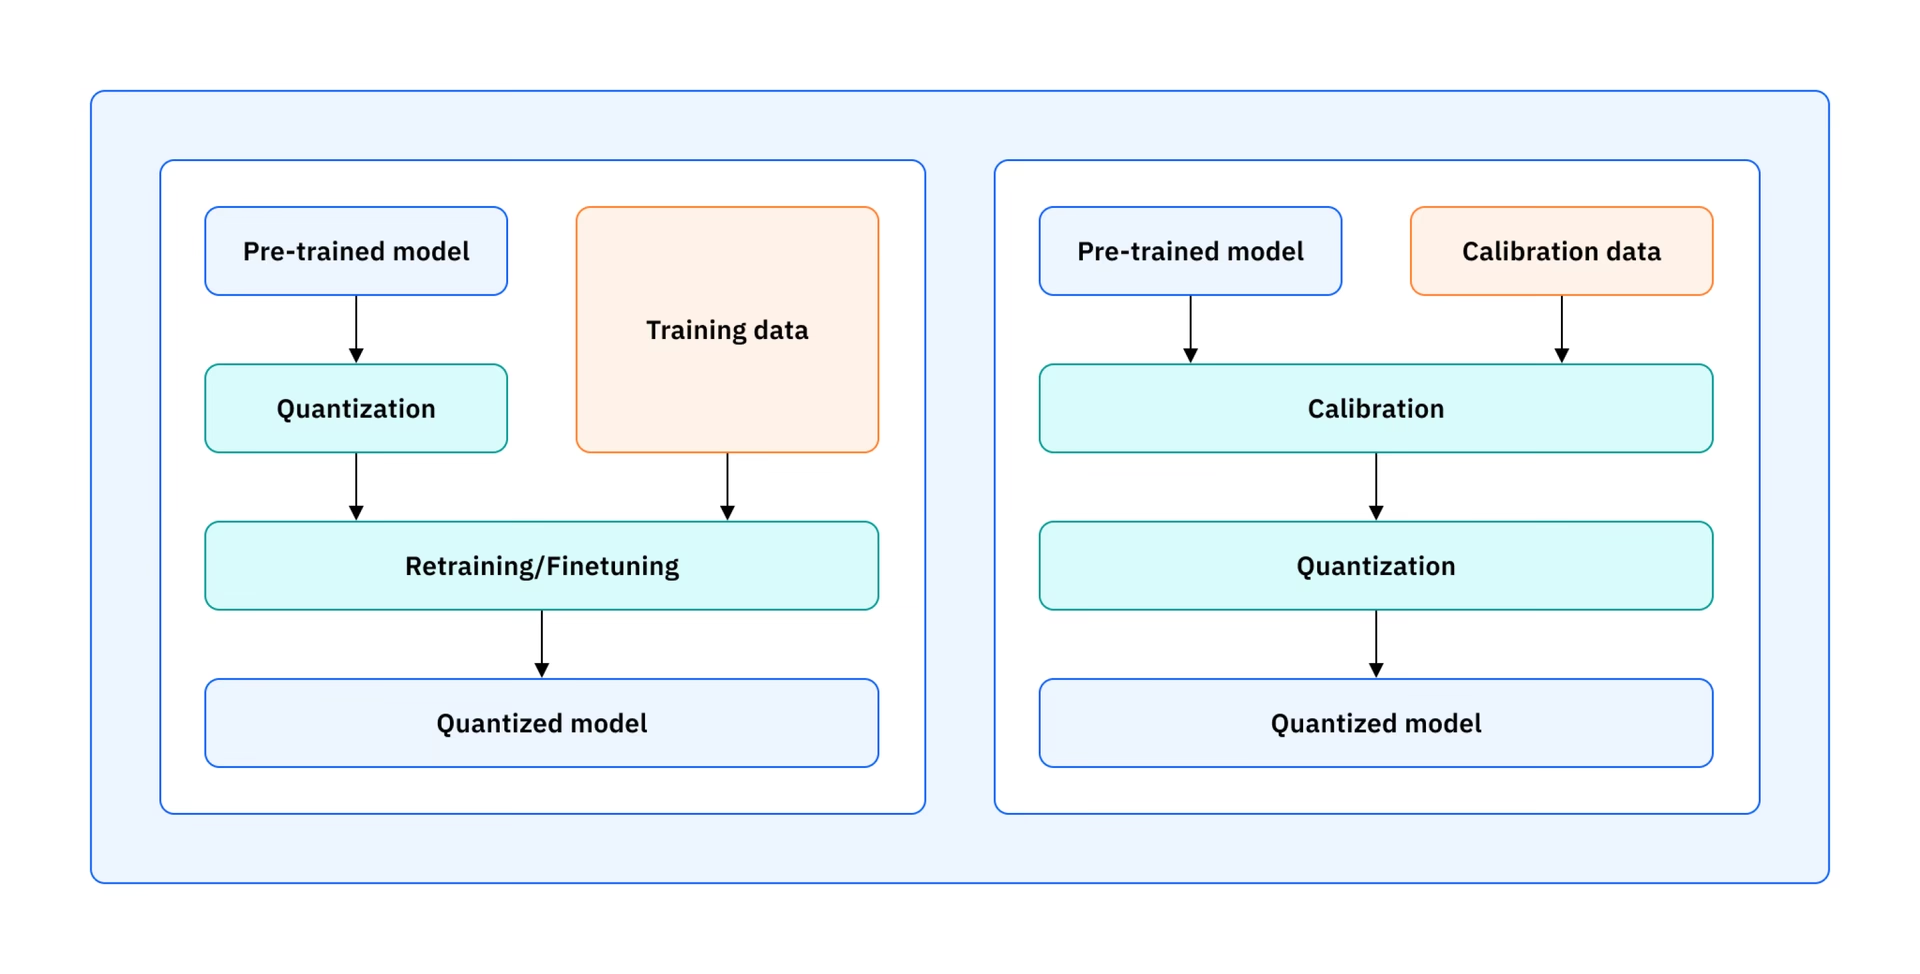
Există două abordări principale ale cuantizării: Cuantizarea Post-Antrenament (Post-Training Quantization - PTQ) și Antrenamentul Conștient de Cuantizare (Quantization Aware Training - QAT).
" + "
Cuantizare Post-Antrenament (PTQ) vs. Antrenament Conștient de Cuantizare (QAT)
" + "
Cuantizarea Post-Antrenament (PTQ) este cea mai simplă metodă. Se aplică unui model deja antrenat, convertind pur și simplu greutățile și/sau activările la o precizie mai mică. Deși este rapidă și ușor de implementat, PTQ poate duce la o scădere semnificativă a preciziei modelului, mai ales dacă modelul este sensibil la zgomotul introdus de reducerea preciziei.
" + "
Antrenamentul Conștient de Cuantizare (QAT), pe de altă parte, este o tehnică mai sofisticată. În loc să cuantizeze modelul după antrenament, QAT simulează efectele cuantizării chiar în timpul procesului de antrenament. Acest lucru se realizează prin inserarea de noduri de "cuantizare falsă" (fake quantization nodes) în graficul modelului. Aceste noduri aproximează operațiile de cuantizare și de-cuantizare, permițând modelului să învețe să compenseze pierderile de precizie introduse de cuantizare. Rezultatul este un model care nu numai că este optimizat pentru implementare pe dispozitive edge, dar își menține și o precizie comparabilă cu cea a modelului original, float32.
" + "
Ce Este Antrenamentul Conștient de Cuantizare (QAT)?
" + "
QAT este, în esență, un proces de "fine-tuning" al unui model pre-antrenat, dar cu o conștientizare explicită a modului în care va fi cuantizat la final. Mecanismul cheie constă în adăugarea de operații de cuantizare și de-cuantizare în timpul propagării înainte (forward pass) și în timpul propagării înapoi (backward pass) în timpul antrenamentului. Aceste operații nu modifică efectiv tipul de date al tensorilor (care rămân float32 pentru antrenament), dar simulează efectele cuantizării, cum ar fi tăierea valorilor în afara unui anumit interval și rotunjirea la cel mai apropiat număr întreg cu precizie redusă. Astfel, modelul "învață" să fie mai robust la erorile introduse de cuantizare.
Beneficiile QAT sunt clare:
" + "
- " + "
- Precizie Superioară: De obicei, QAT oferă o precizie mai bună decât PTQ, mai ales pentru cuantizarea la 8 biți sau mai puțin.
- Performanță Consolidată: Modelele rezultate sunt gata pentru implementare pe hardware specializat care beneficiază de operații cu numere întregi.
- Flexibilitate: Poți alege să cuantizezi întregul model sau doar anumite straturi, pentru a echilibra precizia și optimizarea.
" + "
" + "
" + "
" + "
Cum Creăm un Model Keras Conștient de Cuantizare (QAT)?
" + "
TensorFlow Model Optimization Toolkit oferă API-uri intuitive pentru a implementa QAT în Keras. Procesul implică câțiva pași esențiali:
" + "
1. Definirea unui Model Conștient de Cuantizare
" + "
Un model conștient de cuantizare nu este încă cuantizat, ci este pregătit pentru a fi antrenat în așa fel încât să țină cont de cuantizare. După antrenament, va trebui să-l convertiți într-un model cuantizat efectiv.
" + "
Cuantizarea întregului model: Cea mai simplă abordare este aplicarea QAT la întregul model. Aceasta este recomandată pentru majoritatea cazurilor, în special dacă porniți de la un model pre-antrenat.
" + "
import tensorflow_model_optimization as tfmot
import tf_keras as keras

# Presupunem că 'model_de_bază' este modelul tău Keras pre-antrenat
q_aware_model = tfmot.quantization.keras.quantize_model(model_de_bază)

# Modelul conștient de cuantizare trebuie recompilat
q_aware_model.compile(optimizer='adam',
 loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True),
 metrics=['accuracy'])
q_aware_model.summary()
" + "
După rularea acestui cod, vei observa că în sumarul modelului, majoritatea straturilor vor fi prefixate cu "quant_", indicând că au fost încapsulate în "quantization wrappers".
" + "
Cuantizarea selectivă a straturilor: Uneori, cuantizarea anumitor straturi poate avea un impact negativ asupra preciziei. În aceste cazuri, poți alege să cuantizezi doar anumite straturi, oferind un control mai granular asupra compromisului dintre precizie, viteză și dimensiune.
" + "
Pentru a cuantiza selectiv, se folosește funcția tfmot.quantization.keras.quantize_annotate_layer pentru a marca straturile dorite, apoi tfmot.quantization.keras.quantize_apply pentru a aplica modificările.
" + "
import tensorflow_model_optimization as tfmot
import tf_keras as keras

def aplica_cuantizare_la_dense(layer):
 if isinstance(layer, keras.layers.Dense):
 return tfmot.quantization.keras.quantize_annotate_layer(layer)
 return layer

# Clonați modelul de bază și aplicați funcția de adnotare
model_adnotat = keras.models.clone_model(
 model_de_bază,
 clone_function=aplica_cuantizare_la_dense,
)

# Aplicați cuantizarea
q_aware_model = tfmot.quantization.keras.quantize_apply(model_adnotat)
q_aware_model.compile(optimizer='adam', loss='mse', metrics=['accuracy'])
q_aware_model.summary()
" + "
2. Antrenarea Modelului Conștient de Cuantizare
" + "
Odată ce modelul este definit ca fiind "conștient de cuantizare" și recompilat, procesul de antrenament este similar cu cel al unui model Keras standard. Se recomandă, în general, "fine-tuning-ul" unui model pre-antrenat cu QAT, mai degrabă decât antrenarea de la zero, pentru rezultate mai bune în ceea ce privește precizia.
q_aware_model.fit(imagini_antrenament, etichete_antrenament, epochs=10, validation_split=0.1)" + "
3. Salvarea și Deserializarea Modelelor HDF5 (Doar pentru formatul HDF5)
" + "
Dacă salvezi modelul QAT în format HDF5 (.h5), vei avea nevoie de un context special (quantize_scope) pentru a-l deserializa corect, deoarece conține straturi personalizate adăugate de toolkit-ul de optimizare.
" + "
import tempfile
import os

_, fisier_model_keras = tempfile.mkstemp('.h5')
q_aware_model.save(fisier_model_keras)

with tfmot.quantization.keras.quantize_scope():
 model_incarcat = keras.models.load_model(fisier_model_keras)
model_incarcat.summary()
" + "
4. Crearea și Implementarea Modelului Cuantizat
" + "
După ce ai antrenat modelul QAT, pasul final este convertirea acestuia într-un model cuantizat efectiv, de obicei în formatul TensorFlow Lite (TFLite) pentru implementare pe dispozitive mobile și edge.
" + "
import tensorflow as tf

converter = tf.lite.TFLiteConverter.from_keras_model(q_aware_model)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
model_tflite_cuantizat = converter.convert()
" + "
Modelul rezultat (model_tflite_cuantizat) va avea greutățile în format int8 și activările în uint8, fiind optimizat pentru inferență rapidă și eficientă. Vei observa o reducere drastică a dimensiunii fișierului, de până la 4 ori, cu o pierdere minimă de precizie, grație procesului QAT.
" + "
Experimentarea cu Cuantizarea (Cazuri Avansate)
" + "
Pentru cazuri de utilizare mai specifice sau pentru cercetare, TensorFlow Model Optimization Toolkit permite o personalizare extinsă a procesului de cuantizare. Aceste funcționalități sunt considerate experimentale și nu garantează întotdeauna o cale de implementare directă pe toate backend-urile (de exemplu, TFLite acceptă în principal cuantizarea pe 8 biți).
" + "
- " + "
- Configurarea personalizată a cuantizării (QuantizeConfig): Poți defini cum sunt cuantizate greutățile, activările și ieșirile unui strat. De exemplu, poți schimba numărul de biți pentru cuantizare (ex: 4 biți în loc de 8 biți pentru greutăți).
- Modificarea parametrilor de cuantizare: Poți ajusta parametri precum
num_bits(numărul de biți),symmetric(simetrie) sauper_axis(cuantizare pe axă). Atenție: cuantizarea bias-ului la mai puțin de 32 de biți dăunează adesea preciziei. - Ignorarea cuantizării pentru anumite părți: De exemplu, poți decide să nu cuantizezi activările unui strat specific dacă acestea sunt critice pentru precizie.
- Algoritmi de cuantizare personalizați: Poți chiar implementa propriul algoritm de cuantizare, definind o clasă care moștenește
tfmot.quantization.keras.quantizers.Quantizer.
" + "
" + "
" + "
" + "
" + "
Aceste opțiuni avansate sunt utile pentru a înțelege mai bine impactul cuantizării și pentru a explora limitele acesteia, dar necesită o înțelegere mai profundă a mecanismelor de cuantizare și a modului în care acestea interacționează cu arhitectura modelului tău.
" + "
Comparație: Cuantizare Post-Antrenament (PTQ) vs. Antrenament Conștient de Cuantizare (QAT)
" + "
| Caracteristică | Cuantizare Post-Antrenament (PTQ) | Antrenament Conștient de Cuantizare (QAT) |
|---|---|---|
| Precizie | Poate suferi o scădere notabilă a preciziei. | Menține o precizie aproape de modelul float32. |
| Complexitate | Simplu de implementat, nu necesită re-antrenare. | Mai complex, necesită un proces de fine-tuning. |
| Timp de Implementare | Rapidă. | Necesită timp suplimentar pentru antrenament. |
| Caz de Utilizare | Unde o ușoară scădere a preciziei este acceptabilă, sau ca prim pas de optimizare. | Unde precizia este critică pentru dispozitivele edge. |
| Cerințe de Date | Nu necesită date de antrenament (doar modelul). Unele metode PTQ necesită un set de date reprezentativ. | Necesită setul de date de antrenament pentru fine-tuning. |
" + "
Întrebări Frecvente (FAQ)
" + "
- " + "
- Ce este "cuantizarea falsă" (fake quantization)?
- Este o tehnică folosită în QAT unde operațiile de cuantizare și de-cuantizare sunt simulate în timpul antrenamentului. Tensorii rămân în format float32, dar valorile lor sunt limitate și rotunjite, imitând comportamentul cuantizării pe biți puțini. Aceasta permite rețelei să "învețe" să gestioneze erorile de cuantizare.
- Antrenamentul Conștient de Cuantizare (QAT) este întotdeauna superior Cuantizării Post-Antrenament (PTQ)?
- În general, da, QAT tinde să ofere o precizie mai bună decât PTQ, mai ales când se dorește o cuantizare agresivă (ex. la 8 biți). Cu toate acestea, QAT necesită un efort suplimentar de antrenament și poate fi mai complex de implementat.
- Pot cuantiza doar anumite straturi ale modelului meu?
- Da, TensorFlow Model Optimization Toolkit permite cuantizarea selectivă a straturilor. Acest lucru este util pentru a identifica și a proteja straturile critice care ar putea suferi o pierdere semnificativă de precizie prin cuantizare.
- QAT afectează timpul de antrenament?
- Da, QAT poate crește ușor timpul de antrenament deoarece implică operații suplimentare de cuantizare falsă. Cu toate acestea, beneficiile în ceea ce privește dimensiunea modelului și performanța la inferență depășesc adesea acest cost suplimentar.
- Ce tipuri de modele Keras sunt suportate pentru QAT?
- QAT suportă în general modelele Sequential și Functional API. Modelele subclasate (subclassed models) nu sunt direct suportate pentru cuantizarea întregului model, dar pot fi cuantizate selectiv.
" + "
" + "
" + "
" + "
" + "
" + "
" + "
" + "
" + "
" + "
" + "
Concluzie
" + "
Antrenamentul Conștient de Cuantizare (QAT) reprezintă o tehnică indispensabilă pentru oricine dorește să optimizeze modelele de inteligență artificială Keras pentru implementare pe dispozitive cu resurse limitate. Prin simularea cuantizării în timpul antrenamentului, QAT permite crearea unor modele semnificativ mai mici și mai rapide, păstrând în același timp o precizie remarcabilă. Fie că dezvolți aplicații de fitness care rulează pe wearables, sisteme de monitorizare a sănătății sau orice altă soluție bazată pe AI care necesită eficiență maximă, înțelegerea și aplicarea QAT îți va oferi un avantaj competitiv. Încearcă această capacitate puternică și transformă-ți modelele AI în soluții performante și eficiente energetic!
Dacă vrei să descoperi și alte articole similare cu Antrenament Conștient de Cuantizare (QAT) în Keras, poți vizita categoria Fitness.